数据输入软件,操作后窗口里跳出七八张表。有一格里写着"显著性0.000",另一格里写着0.656,还有一个加粗的0.734。多数人到这里就卡住了:到底该看哪一个,这几个数分别说明了什么,能不能就此在论文里写下一句"A对B有显著影响"?
9月12日,SBS瑞士商学院工商管理博士项目的《高级定量分析与应用》(上)课堂上,王教授从统计思维的四条基本常识讲起,依次覆盖描述性统计、T检验与方差分析、相关分析与卡方检验、判别分析、线性回归、曲线估计和逻辑回归,每讲完一种方法,就带着同学们用真实数据在软件里从头跑一遍、把结果逐行读完。
对同学们的学术训练来说,它填的是"跑得出来"和"说得清楚"之间的那道缝隙——知道该报告哪个数、这个数凭什么支撑结论、表里没通过的那一行意味着什么;对日常管理来说,它校正的是更隐蔽的一个习惯:一个常年看平均数、看同比增长的人,怎么改掉"数字高一点就等于好一点"的下意识判断。
你不擅长数学,这丝毫不影响你把统计学学好
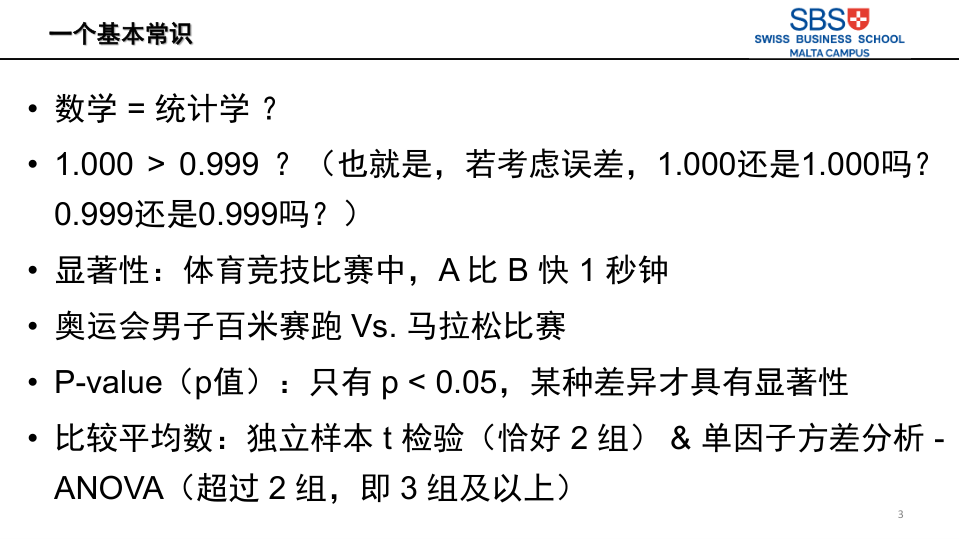
课程一开始,王教授先给部分同学卸包袱。不少人有顾虑:数学底子薄,高级定量分析这门课怎么听得下来。他的回答很干脆——数学并不等于统计学。学统计当然会用到数学,但用到的只是很基础的那部分,"你不擅长数学,这丝毫不影响你把统计学学好"。
为了让这句话落地,他先抛了一个小学生都能回答的问题:1.000大于0.999吗?
在数学里,这是一道送分题。但放到统计学里,答案未必成立。因为这两个数都不是算出来的,是测出来的;一旦把测量过程里必然存在的误差考虑进去,你就无法铁口直断前者一定比后者大。
紧接着是"显著性"这个词。他用了体育比赛做比方:同样是快出一秒,马拉松领先一秒,再比十次未必还能领先;男子百米领先一秒,几乎可以断言再比一百次还是他赢。同样的一秒,放在不同场合,分量完全不同。这就是显著性要表达的东西,而它在统计里最终会落到一个具体的数上——P值。P值小于事先设定的显著性水平,说明"两者没有差别"这个前提站不住,差异才算真的存在。
十个假设全部成立的那天,恰恰要警惕
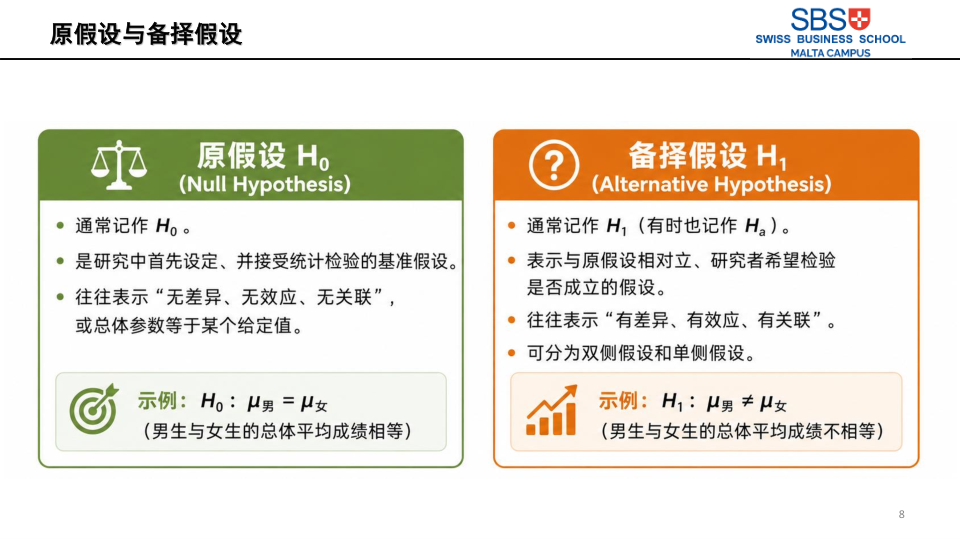
有了P值,就要有假设。课上反复强调的一条潜规则是:原假设永远设定为"无差异、无效应、无关联"。像法官先假定嫌疑人无罪一样,只有证据足够强,才推翻它、接受备择假设。
有同学问:辛辛苦苦收来的数据,跑完发现假设不成立,论文是不是白做了?他的回答正好相反——这恰恰是你出彩的地方。他打了个比方:提出十个假设,十个全部成立,这只是一篇合格的论文;提出十个假设,七个成立三个不成立,而你又能把那三个为什么不成立讲得自圆其说,这才叫和前人不一样的新发现。结果太漂亮,本身就不是好消息。
怕同学们概念混用,他又把两类错误拆开讲。假定被告无罪,实际也无罪、判决也无罪,这是正确的判断;被告有罪、判决也有罪,同样正确。错的是另外两种情形:被告其实无罪,法官判他有罪;被告其实有罪,法官判他无罪。前一种是"太敏感",像厨房里一开火就尖叫的报警器,把没病的人判成有病;后一种是"太迟钝",火烧起来了报警器还纹丝不动。两类都要避免,但相对而言,更要盯住前者。
至于显著性水平,他也给了很务实的口径:管理学论文取0.05就够了,生物医学领域可能要严到0.01。
先看清X和Y是哪种变量,再谈用什么方法
整门课的骨架,其实是测量"谁对谁的影响"。王教授强调:工商管理博士论文本质上就是在研究谁对谁的影响,将来开题的时候,一定要说清楚自己的变量是什么。
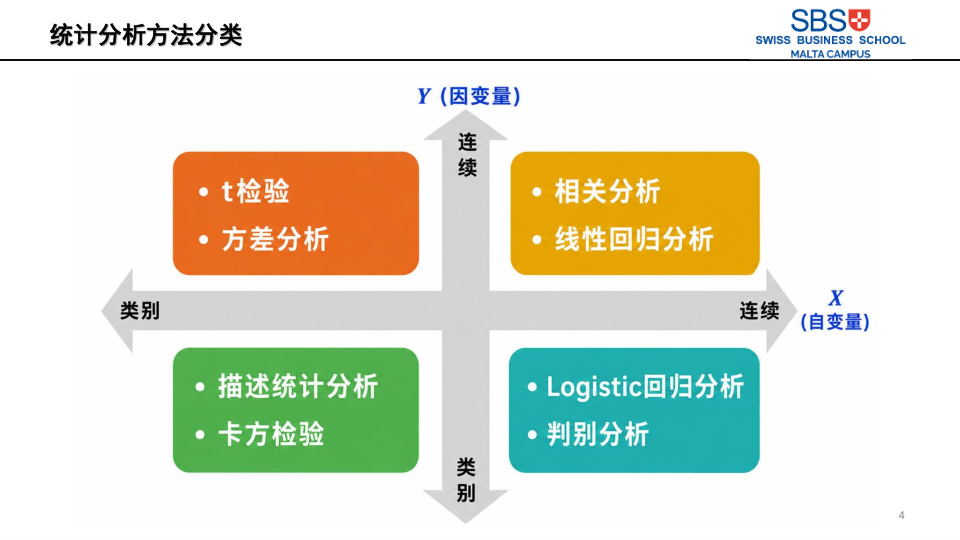
而变量的类型决定了方法的选择,王教授解释到:
因变量是连续变量、自变量只有两个类别时,用独立样本T检验;类别超过两个,就不要再用T检验了,改用方差分析,它可以先作方差齐性检验、再用事后比较去定位到底哪两组之间不同。自变量和因变量都是类别变量时,用卡方检验,看某个群体的分布与预期或另一群体是否一致。两个连续变量之间的方向与强度,看相关分析。因变量连续、自变量也连续且不止一个,就进入回归的世界。因变量本身是"买或不买""是否逾期"这类二分类变量,线性回归就不再适用,要换逻辑回归或判别分析。
而在统计推断之前,最容易被学员忽略的,是看起来平平无奇的描述性统计分析。王教授强调:虽然看起来谁都会,但博士论文恰恰也需要这块东西。原因很简单。假设请一批在校大学生帮忙填问卷,跑完描述性统计分析发现20到25岁占百分之百,30岁以上一个都没有,学历清一色本科在读,那评审一眼就能看出样本偏了。频率分布是别人判断你这份数据到底覆盖了哪些人的唯一依据,它决定了后面所有结论能不能被采信。
冰淇淋卖得越多,溺水的人越多——相关不是因果
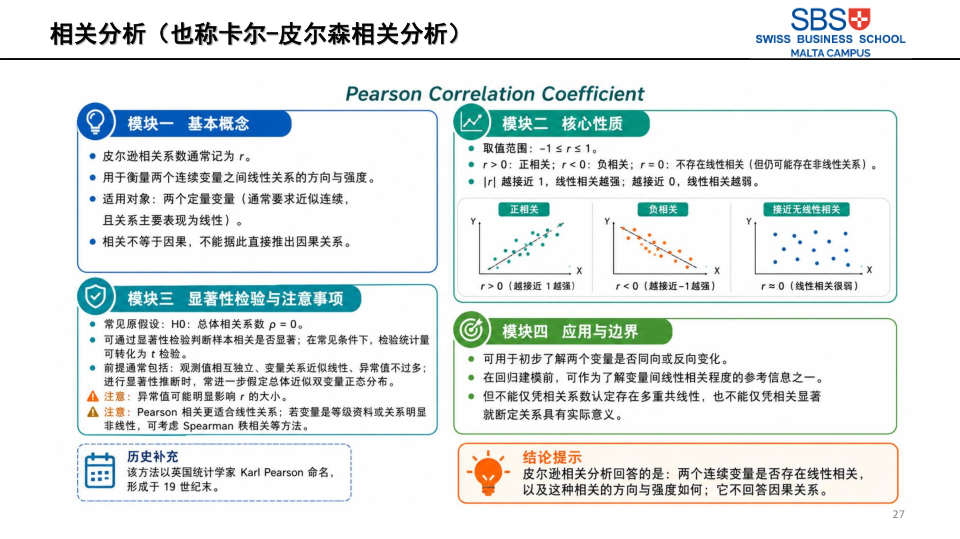
两个变量一起涨,不等于一个引发了另一个。课上用了那个经典例子:冰淇淋销量和海边溺亡人数高度相关,但背后的共同原因是天气炎热。用他的话说,相关系数只能告诉你相不相关,推不出谁因谁果。
皮尔森系数衡量的是两个连续变量之间线性关系的方向和强度,取值在负一到一之间。经验上看,0.8以上算极强相关,0.6到0.79是较强,0.4到0.59属中等。相关度高到一定程度,就引出另一个麻烦——共线性。
他用员工的年龄和工龄来解释:一个人年纪越大,在公司服务的年限通常也越长,两个变量高度重合,研究其对业绩的影响时保留一个就够了。放到多元回归里,自变量之间的关系被说得更形象:就像给新领导配了十个人,其中有两位的技能高度重叠,完全可以去掉一个。
马力单独显著,加进去反而不显著了
课程接下来的重头戏是线性回归,而全天最精彩的一段推理,出现在一份汽车数据上。
要解释的是每公升汽油能跑多少公里,候选自变量有三个:排气量、马力和车重。先只放车重,它能解释七成多的里程变异。把三个一起放进去,结果出现了有意思的一幕:马力这一行没能通过检验,P值停在0.656。
有同学当场糊涂了——单独跑马力的时候它是显著的,怎么放在一起就不行了?王教授的解释是:马力的解释力被排气量和车重稀释掉了。换句话说,有了后两个变量,马力变成了多余的那个。两次结果都没错,错的是把"单独显著"直接等同于"放进模型也一定有用"。
这里还有一层顺序不能颠倒:先看整体检验那张表,它显著只说明三个系数里至少有一个不等于零,并不等于三个都成立;再逐个看每个自变量的检验结果,谁通过谁不通过才算清楚。
紧跟着是R2。自变量越多,R2只会越来越大,这种"虚胖"需要用调整后的R2来抵消——自变量超过两个时,必须报告调整后的R2。这一例调整后的R2是0.734,剩下约四分之一进到残差里,由模型没能纳入的原因去解释。他的提醒是:显著性没过之前,R2再高也没有意义;过了显著性再比R2,这时候的比较才有价值。
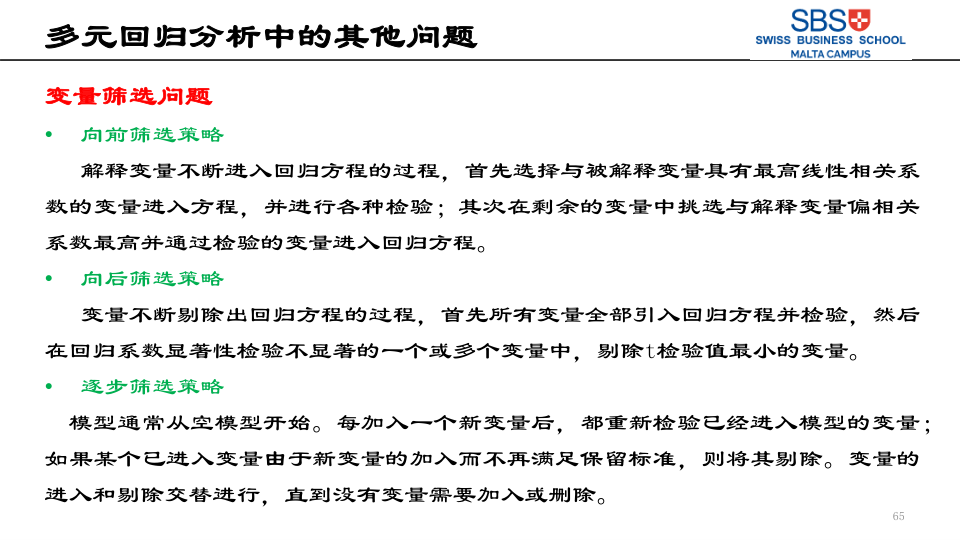
变量怎么进模型,也被讲成了三个策略:向前筛选是从最相关的一个开始往里加,向后筛选是把所有变量放进去再逐个剔除,逐步筛选是两者的组合。落到操作层面,他更推荐向前筛选。而残差——预测值和真实值之间的距离——被他反复强调:这条回归线只刻画自变量变化时,因变量的平均水平怎么变,不能凭它说某件事一定导致另一件事。
弯的线,可以先掰直了再算
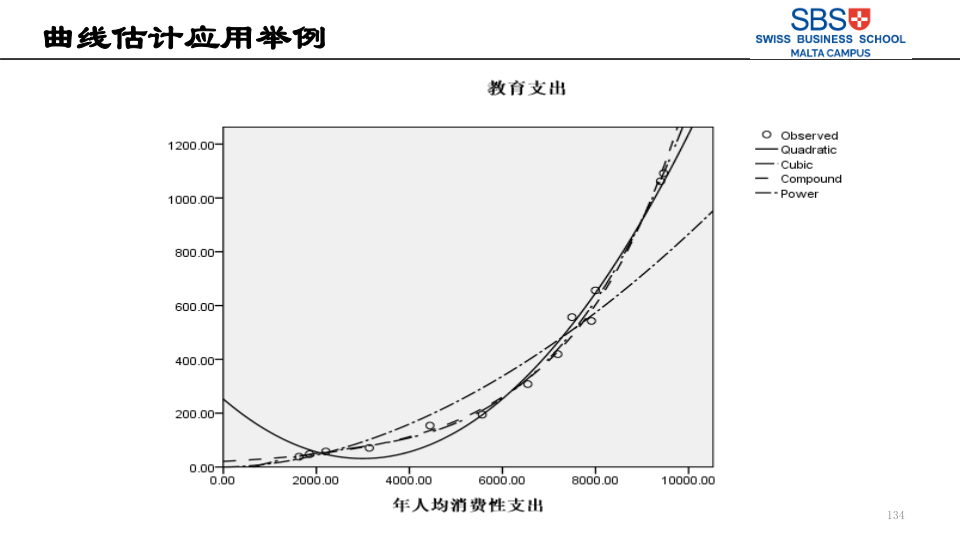
现实中两个变量的关系未必是一条直线。曲线估计这一节处理的就是"看起来非线性、其实能转化"的那类问题:二次曲线把X2定义成一个新变量,复合曲线两边取对数把乘方变成加法,对数曲线把X取对数后当作新变量——转完之后,全部可以用线性回归的办法解决。
这个操作也在一组教育支出的数据上进行了演示。制图出来先看形状,明显不是直线。于是二次、三次、复合、幂函数四种模型一起跑:二次模型的R2很高、也通过了检验,但系数是负的,意味着人均消费支出越高、教育支出反而越低,这与事实相悖,直接淘汰;三次模型的显著性没能通过;剩下复合函数和幂函数都成立。
二选一时他给了一个贴近业务的判断:复合函数的增长速度高于幂函数,而教育支出在居民消费中的占比逐年抬升,未来大概率继续快速增长——按这个趋势,复合函数更合适。这个取舍很能说明这门课的气质:模型好不好,先看显著性,再看解释力,最后还要回到现实中讲不讲得通。
结果只有"买"和"不买"时,线性回归就不够用了
最后一部分留给逻辑回归。它的场景极其常见:因变量只有两种取值——买或不买、是否违约、是否幸存。自变量照样是连续的。
难点在于,概率的取值在零到一之间,而右边的线性组合可以跑到正负无穷,两边对不上。解决办法是引入优势比:用事件发生的概率除以不发生的概率,把零到一拉到零到正无穷;再取一次对数,区间被拉到正负无穷,左右两边这才匹配。算出来的结果落在零到一之间,就是那个"发生"的概率。
看起来式子相当唬人,但王教授点破了它的本质——它仍然是一个线性分类器,画一条直线把样本分开。还有一个细节容易被忽视:判定"发生"的阈值不要机械地取0.5,通常会参考样本中"发生"所占的比例来确定。
看平均数下判断,是管理者最熟练的动作,也是最难改掉的动作。一整天的课程做的,就是在每一次"这个数更高"的决策前,先插入一句追问:这个差距,能用偶然解释掉吗?